Aus Dokumenten werden strukturierte Daten – mit flexibler KI-Architektur
Wenn wichtige Informationen erst aus Dokumenten übertragen werden müssen
Viele digitale Prozesse beginnen mit einem Dokument. Darin stehen bereits Informationen, die für die weitere Bearbeitung benötigt werden – sie liegen jedoch zunächst nicht in einer Form vor, in der Anwendungen sie direkt weiterverarbeiten können.
Ein Beispiel ist die digitale Mandatsannahme in einer Kanzlei: Eine ratsuchende Person übermittelt ihr Anliegen und lädt dazu relevante Unterlagen hoch. Bei einer arbeitsrechtlichen Anfrage kann das etwa ein Kündigungsschreiben sein. Angaben wie Name, Arbeitgeber oder relevante Datumsangaben sind darin bereits enthalten.
Müssen diese Informationen anschließend noch einmal manuell erfasst und übertragen werden, entstehen zusätzliche Arbeitsschritte und mögliche Fehlerquellen.
Gleichzeitig sollte die technische Architektur unterschiedliche Anforderungen an Datenschutz, Sicherheit und Datenhoheit berücksichtigen können und nicht dauerhaft an einen einzelnen KI-Anbieter gebunden sein.
Automatisierung und Datenkontrolle zusammendenken
Bei Dokumenten wie einem Kündigungsschreiben geht es nicht nur darum, Informationen möglichst komfortabel und schnell zu erfassen. Die Dokumente können sensible und vertrauliche Inhalte enthalten.
Damit wird auch die Wahl der eingesetzten KI-Technologie relevant:
- Welches Modell verarbeitet die Daten?
- Wo findet die Verarbeitung statt?
- Und wie abhängig ist die Anwendung von einem bestimmten Anbieter?
Die Lösung sollte deshalb so konzipiert werden, dass für einzelne Verarbeitungsschritte unterschiedliche KI-Modelle eingesetzt werden können. So lässt sich die technische Umsetzung an das erforderliche Niveau von Datenschutz, Datenhoheit und Anbieterunabhängigkeit anpassen.
Erst lesen, dann Informationen gezielt zuordnen
Damit Informationen aus einem Dokument automatisch weiterverarbeitet werden können, verbindet die Lösung zwei unterschiedliche Fähigkeiten.
Text erkennen
Die Texterkennung (OCR) erkennt Text in PDF-Dateien, Scans oder Bildern und macht ihn maschinenlesbar.
Aus einem hochgeladenen Dokument entsteht damit Text, den die Anwendung automatisiert weiterverarbeiten kann.
Informationen erkennen und strukturieren
Im nächsten Schritt identifiziert die Datenextraktion die Informationen, die für den jeweiligen Prozess benötigt werden. Sie erkennt beispielsweise, welche Textbestandteile einen Namen, ein Datum oder einen Arbeitgeber bezeichnen, und ordnet sie den entsprechenden Datenfeldern zu.
So wird aus einem Dokument nicht nur maschinenlesbarer Text, sondern eine strukturierte Grundlage für die weitere Bearbeitung.
Vom Kündigungsschreiben zur strukturierten Mandatsanfrage
Wie das praktisch funktioniert, zeigt das Beispiel einer digitalen Mandatsannahme.
Eine ratsuchende Person wählt online zunächst das passende Rechtsgebiet aus, beispielsweise Arbeitsrecht, und lädt ihr Kündigungsschreiben als PDF hoch.
Die Texterkennung macht den Inhalt des Dokuments maschinenlesbar. Anschließend erkennt die Datenextraktion die für die Anfrage benötigten Angaben – etwa Name, Arbeitgeber und relevante Datumsangaben – und übernimmt sie in die vorgesehenen Felder.
Die Person muss diese Informationen nicht noch einmal vollständig von Hand eingeben. Fehlen Angaben oder können sie nicht eindeutig erkannt werden, lassen sie sich gezielt ergänzen oder korrigieren.
Für die Kanzlei stehen die Informationen anschließend bereits strukturiert für die weitere Bearbeitung der Anfrage zur Verfügung.
Die Aufgabe bleibt gleich. Das KI-Modell kann wechseln.
Texterkennung und Datenextraktion sind klar definierte Aufgaben – welches KI-Modell sie übernimmt, muss jedoch nicht dauerhaft festgelegt sein.
Für beide Verarbeitungsschritte können unterschiedliche Modelle eingesetzt werden. Neben cloudbasierten Angeboten kommen beispielsweise auch Open-Weight-Modelle infrage, die auf kontrollierter Infrastruktur betrieben werden können.
Welche Kombination sinnvoll ist, richtet sich nach den Anforderungen des jeweiligen Einsatzes – beispielsweise an Leistungsfähigkeit, Datenschutz, Datenhoheit, Infrastruktur oder Anbieterunabhängigkeit.
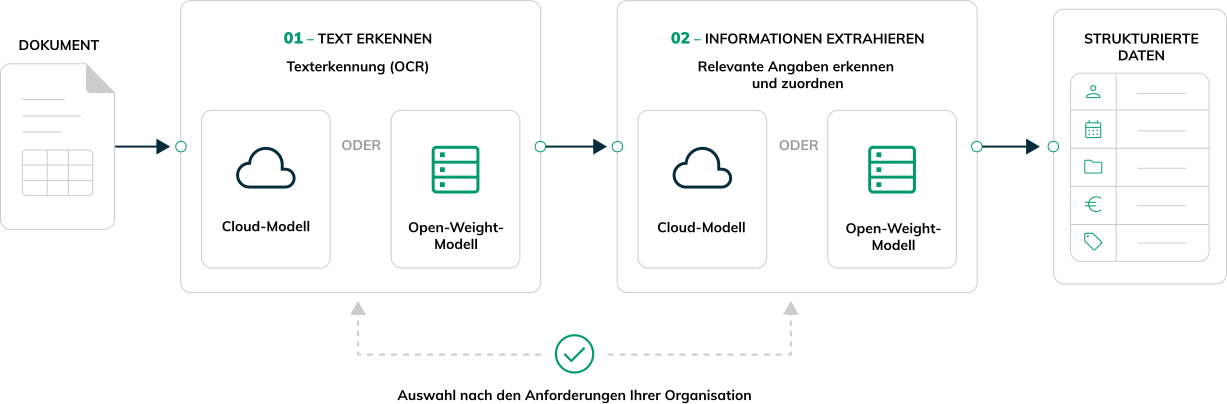
Für jeden Verarbeitungsschritt kann das KI-Modell passend zu den jeweiligen Anforderungen gewählt werden.
Kontrolle behalten, wenn die KI nicht eindeutig entscheiden kann
Automatisierte Datenextraktion bedeutet nicht, dass jedes erkannte Ergebnis ungeprüft übernommen werden muss.
Fehlen Informationen oder kann eine Angabe nicht eindeutig zugeordnet werden, weist die Anwendung darauf hin. Die betreffende Information kann anschließend durch den Menschen geprüft, ergänzt oder korrigiert werden.
Dieses Human-in-the-Loop-Prinzip verbindet automatisierte Verarbeitung mit menschlicher Kontrolle dort, wo sie fachlich notwendig ist.
Die Betriebsform richtet sich nach den Anforderungen
Die Wahlfreiheit endet nicht beim KI-Modell. Abhängig von den Anforderungen der Organisation kann auch entschieden werden, auf welcher Infrastruktur die Verarbeitung stattfindet.
Neben cloudbasierten Diensten können Open-Weight-Modelle auf einer kontrollierten Infrastruktur betrieben werden. Damit lässt sich beispielsweise eine Lösung realisieren, bei der die Verarbeitung auf Servern in Deutschland erfolgt.
So können Organisationen die technische Architektur daran ausrichten, welche Anforderungen sie an Datenschutz, Sicherheit, Compliance und Datenhoheit stellen – und Abhängigkeiten von einzelnen Anbietern reduzieren.
Weniger manuelle Erfassung, mehr Flexibilität
Die automatisierte Dokumentenverarbeitung reduziert wiederkehrende Arbeitsschritte und stellt benötigte Informationen strukturiert für nachgelagerte Prozesse bereit. Gleichzeitig bleibt die technische Architektur an unterschiedliche Anforderungen anpassbar.
Wahlfreiheit statt technologischer Festlegung
Dieses Projekt zeigt, dass souveräne KI nicht bedeutet, grundsätzlich ein bestimmtes Modell oder eine bestimmte Betriebsform zu wählen. Entscheidend ist, Wahlmöglichkeiten zu erhalten und die technische Lösung an den eigenen Anforderungen ausrichten zu können.